AUF DIESER SEITE
Was sind Sonden?
Sondierungen sind die grundlegende Abstraktionseinheit in Intent-Based Analytics. Im Allgemeinen verbraucht eine gegebene Sonde einen Satz von Daten aus dem Netzwerk, führt verschiedene aufeinanderfolgende Aggregationen und Berechnungen darauf durch und gibt optional einige Bedingungen dieser Aggregationen und Berechnungen an, auf denen Anomalien ausgelöst werden.
Sondierungen sind gerichtete azyklische Graphen (DAGs), bei denen die Knoten des Graphen Prozessoren und Phasen sind. Phasen sind kontextbezogene Daten, die vom Bediener überprüft werden können. Prozessoren sind Sätze von Vorgängen, die Ausgabedaten aus Eingabedaten erzeugen und reduzieren. Die Eingabe an Prozessoren besteht aus einer oder mehreren Stufen, und die Ausgabe von Prozessoren besteht ebenfalls aus einer oder mehreren Stufen. Die Richtungsabhängigkeit der Kanten in einem Probe-DAG stellt diesen Input-to-Output-Fluss dar.
Wichtig ist, dass die anfänglichen Prozessoren in einer Sonde speziell sind und keine Eingangsstufe haben. Sie sind gedanklich Generatoren von Daten. Wir bezeichnen diese als Quellprozessoren.
Bei IBA werden rohe Telemetriedaten von Kollektoren in Sonden aufgenommen, um daraus Erkenntnisse (z. B. Anomalien, Aggregationen usw.) zu extrahieren. Ein bestimmter Collector veröffentlicht Telemetriedaten als Sammlung von Metriken, wobei jede Metrik eine Identität (d. h. eine Reihe von Schlüssel-Wert-Paaren) und einen Wert aufweist. IBA-Sondierungen müssen die Identität einer Metrik, die häufig mithilfe von Graphabfragen durchgeführt wird, vollständig angeben, um ihren Wert in die Sondierung aufzunehmen. Mit dieser Funktion können Sondierungen Metriken mit teilweiser Identitätsangabe mithilfe von Aufnahmefiltern erfassen und so die Erfassung von Metriken mit unbekannten Identitäten ermöglichen.
Einige Sondierungen werden automatisch erstellt. Diese Sondierungen werden nicht automatisch gelöscht. Dies hält die Dinge sowohl in Bezug auf den Betrieb als auch auf die Implementierung einfach.
Prozessoren
Die Eingabeprozessoren einer Sondierung übernehmen die erforderliche Konfiguration, um Telemetrierohdaten in die Sondierung einzuspeisen und die Datenverarbeitungspipeline zu starten. Bei diesen Prozessoren entspricht die Anzahl der Phasenausgabeelemente (eines oder mehrere) der Anzahl der Ergebnisse in den angegebenen Graphabfragen. Zum Beispiel, wenn mehrere Graphabfragen angegeben sind. graph_query: [A, B]und Abfrage A mit 5 Knoten und Abfrage B mit 10 Knoten übereinstimmt, sind die Ergebnisse von Abfrage A mit query_result Indizes von 0 bis 4 und die Ergebnisse von Abfrage B mit Indizes von 5 bis 14 zugänglich.
Wenn der Eingabetyp und/oder Ausgabetyp eines Prozessors nicht angegeben ist, nimmt der Prozessor eine einzelne Eingabe entgegen, die aufgerufen wird, und erzeugt eine einzelne Ausgabe, die aufgerufen wird.
Einige Prozessorfelder werden als Ausdrücke bezeichnet. In einigen Fällen handelt es sich um Graphabfragen , die so vermerkt sind. In anderen Fällen handelt es sich um Python-Ausdrücke , die einen Wert ergeben. Im Accumulate-Prozessor kann die Dauer z. B. als Ganzzahl mit Sekunden 900oder als Ausdruck angegeben werden. 60 * 15 Ausdrücke könnten jedoch nützlicher sein: Es gibt mehrere Möglichkeiten, sie zu parametrisieren.
Ausdrücke unterstützen Zeichenfolgenwerte. Prozessorkonfigurationsparameter, bei denen es sich um Zeichenfolgen handelt und Ausdrücke unterstützt, sollten beim Angeben eines statischen Werts spezielle Anführungszeichen verwenden. Zum Beispiel ist es ungültig, state: "up" weil es sich auf die Variable "up" bezieht, nicht auf eine statische Zeichenfolge, daher sollte es sein: state: '"up"'.
Ein Ausdruck ist immer einer Graphabfrage zugeordnet und wird für jede resultierende Übereinstimmung dieser Abfrage ausgeführt. Der Ausführungskontext des Ausdrucks ist derart, dass jede in der Abfrage angegebene Variable in einen benannten Knoten im zugeordneten Übereinstimmungsergebnis aufgelöst wird. Weitere Informationen finden Sie unter Service Collector-Beispiel .
Graphbasierte Prozessoren wurden um query_tag_filter erweitert, mit denen Sie Graphabfrageergebnisse nach Tags filtern können. In IBA-Sondierungen werden Tags nur als Filterkriterien für Server und externe Router verwendet, insbesondere für die Prüfung ECMP-Ungleichgewicht (externe Schnittstellen) und die Probe für den gesamten Ost-/Westverkehr. Spezifische Prozessorinformationen finden Sie unter Probeprozessoren im Abschnitt Referenzen .
Einspeisungsfilter
Mit "Erfassungsfiltern" kann ein Abfrageergebnis mehrere Metriken in eine Sondierung aufnehmen. Tabellendatentypen werden verwendet, um mehrere Metriken als Teil eines einzelnen Ausgabeelements zu speichern. Zu den Tabellendatentypen gehören , , -, um vorhandenen Typen zu entsprechen - dssts ns, , -. table_ts table_dsstable_ns
IBA-Erfassungsfilter
Erfassungsfilter bestimmen die Metriken, die von den Zielgeräten erfasst werden.
Ein Erfassungsfilter für einen bestimmten Kollektor auf einem bestimmten Gerät ist einfach eine Sammlung von Erfassungsfiltern, die in verschiedenen Sondierungen vorhanden sind. Sie können sie auch als Teil der Aktivierung eines Service außerhalb des Kontexts von IBA oder Sondierungen angeben, aber hier gelten die vorhandenen Rangfolgenregeln für die Serviceaktivierung – nur Filter auf einer bestimmten Prioritätsebene werden aggregiert. Wenn mehrere Sondierungen einen Erfassungsfilter angeben, der auf einen bestimmten Dienst auf einem bestimmten Gerät abzielt, sind die erfassten Metriken eine Einheit, d. h., eine Metrik wird veröffentlicht, wenn sie mit einem der Filter übereinstimmt. Aus diesem Grund werden die Daten vor der Aufnahme in die IBA-Probes auch nach der Controller-Komponente gefiltert.
Dieser Filter wird von Telemetriesammlern ausgewertet, um häufig besser steuern zu können, welche Teilmenge der verfügbaren Metriken vom zugrunde liegenden Gerätebetriebssystem abgerufen wird (z. B. um nur eine Teilmenge der Routen abzurufen, anstatt alle Routen abzurufen, was eine große Zahl sein kann). In jedem Fall werden nur die Metriken, die dem Sammlungsfilter entsprechen, als unformatierte Telemetriedaten veröffentlicht.
Im Rahmen der Aktivierung eines Dienstes auf einem Gerät können Sie jetzt Sammlungsfilter für Dienste angeben. Dieser Filter wird zu einer zusätzlichen Eingabe, die Collectors als Teil von "self.service_config.collection_filters" zur Verfügung gestellt wird.
IBA-Filterformat
Im Folgenden sind die Design-/Benutzerfreundlichkeitsziele für Filter (Aufnahme und Sammlung) aufgeführt
- Einfaches Authoring: Vorausgesetzt, die Probe-Autoren sind diejenigen, die sie spezifizieren
- In den meisten Fällen handelt es sich um die Übereinstimmung mit irgendetwas, den Abgleich mit einer bestimmten Liste möglicher Werte, die Gleichheitsübereinstimmung, die Bereichsprüfung, ob der Schlüssel numerische Werte hat.
- Effiziente Auswertung – da die Filter in den Hot Paths der Erfassung oder Erfassung ausgewertet werden.
- Aggregierbar - mehrere Filter werden aggregiert, sodass diese Aggregationslogik nicht in die Verantwortung einzelner Kollektoren übergehen muss.
- Programmiersprachenneutral - Komponenten, die auf Filtern arbeiten, können in Python oder C++ oder in Zukunft in einer anderen Sprache sein.
- Programmierbar - Seien Sie offen für zukünftige Programmierbarkeit rund um die Filter, durch den Controller selbst und/oder Kollektoren, um Dinge wie Benutzerfreundlichkeit, Leistung usw. zu verbessern.
Unter Berücksichtigung der oben genannten Ziele finden Sie im Folgenden ein vorgeschlagenes und anschauliches Schema für Filter1. In den Abschnitten zum Erfassungsfilter finden Sie spezifische Beispiele, um dies besser zu verstehen.
FILTER_SCHEMA = s.Dict(s.Object(
  'type': s.Enum(['any', 'equals', 'list', 'pattern', 'range', 'prefix']),
  'value': s.OneOf({
    'equals': s.OneOf([s.String(), s.Integer()]),
    'list': s.List(s.String(), validate=s.Length(min=1)),
    'pattern': s.List(s.String(), validate=s.Length(min=1)),
    'range': s.AnomalyRange(), validate=s.Length(min=1),
    'prefix': s.Object({
      'prefixsubnet': s.Ipv6orIpv4NetworkAddress(),
      'ge_mask': s.Optional(s.Integer()),
      'le_mask': s.Optional(s.Integer()),
      'eq_mask': s.Optional(s.Integer())
  })
), key_type=s.String(description=
  'Name of the key in metric identity. Missing metric identity keys are '
  'assumed to match any value'))
Eine Instanz der Filterspezifikation wird als AND aller angegebenen Schlüssel interpretiert (auch bekannt als Einschränkungen pro Schlüssel). Mehrere Filterspezifikationen, die von mehreren Sonden stammen, werden auf Filterebene als OR betrachtet.
Das hier vorgestellte Schema dient nur der Kommunikation der Anforderungen. Sie können jeden Weg wählen, der die angegebenen Anwendungsfälle erfüllt.
Auf Collector-Prozessoren additional_properties die in der Konfiguration der Collector-Prozessoren angegeben sind, kann über den speziellen context. Namespace zugegriffen werden. Wenn ein Collector z. B. eine Eigenschaft system_roledefiniert, kann sie folgendermaßen verwendet werden:
duration: 60 * (15 if context.system_role == "leaf" else 10)
Der Elementkontext ist verfügbar, solange der Elementsatz gegenüber dem ursprünglichen Satz unverändert ist, der aus der Kollektorprozessorkonfiguration abgeleitet wurde. Nachdem Daten einen Prozessor durchlaufen haben, der diesen Satz ändert, sind sie nicht mehr verfügbar (z. B. ein Gruppierungsprozessor).
Navigieren Sie im Blueprint zu Analytics > Sondierungen , um zur Tabellenansicht "Sondierungen" zu gelangen. Sie können Sondierungen instanziieren, erstellen, klonen, bearbeiten, löschen, importieren und exportieren.
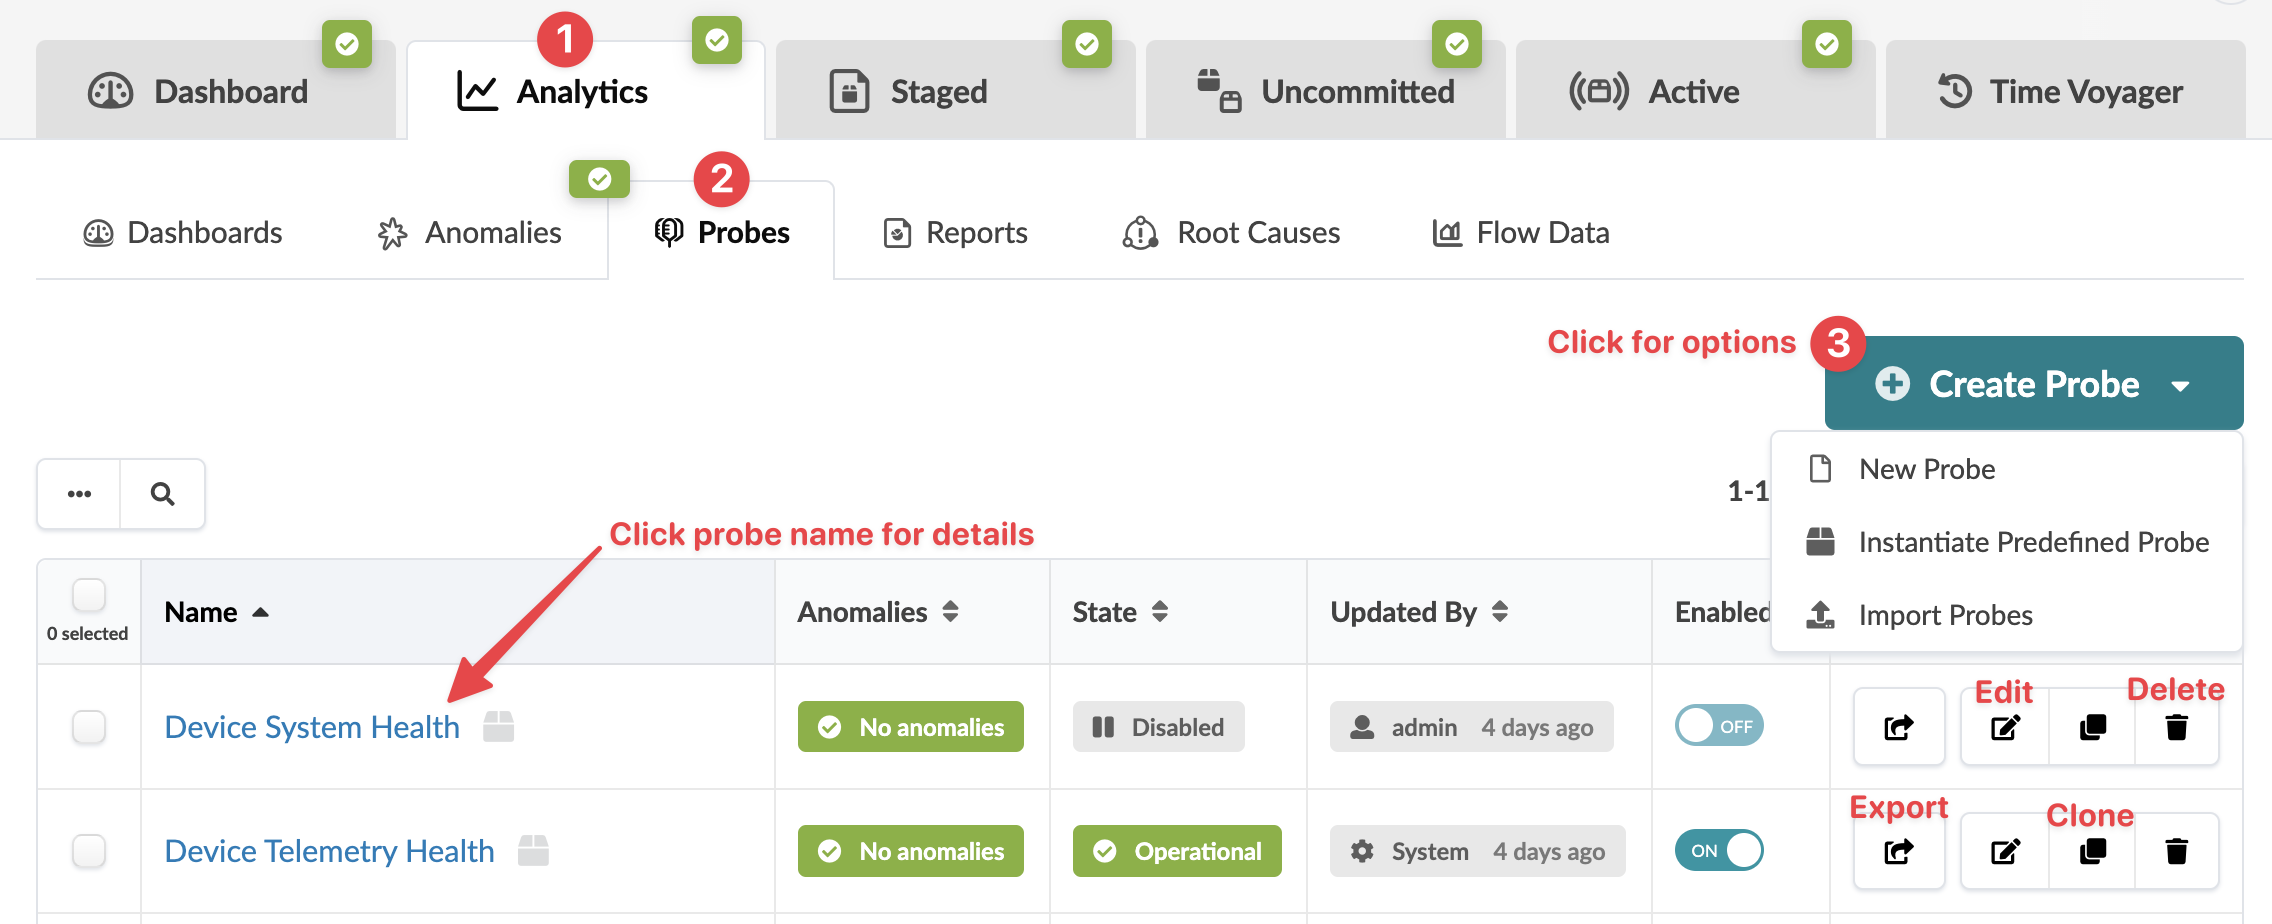
Um zu den Details einer Sondierung zu gelangen, klicken Sie auf ihren Namen. Sie können einen Test in der Tabellenansicht oder in der Detailansicht aktivieren/deaktivieren. In einigen Sondierungen können Sie Phasen auf verschiedene Weise anzeigen. Wenn Sie z. B. auf den Test mit dem Namen Gerätesystemintegrität klicken, wird die folgende Abbildung angezeigt. Sie können die Datenquelle auswählen (Echtzeit, Zeitreihen, Telemetriedienstwarnungen) und dann die Daten auf verschiedene Weise aggregieren. Außerdem wird der für die einzelnen Sonden verwendete Speicherplatz angezeigt.
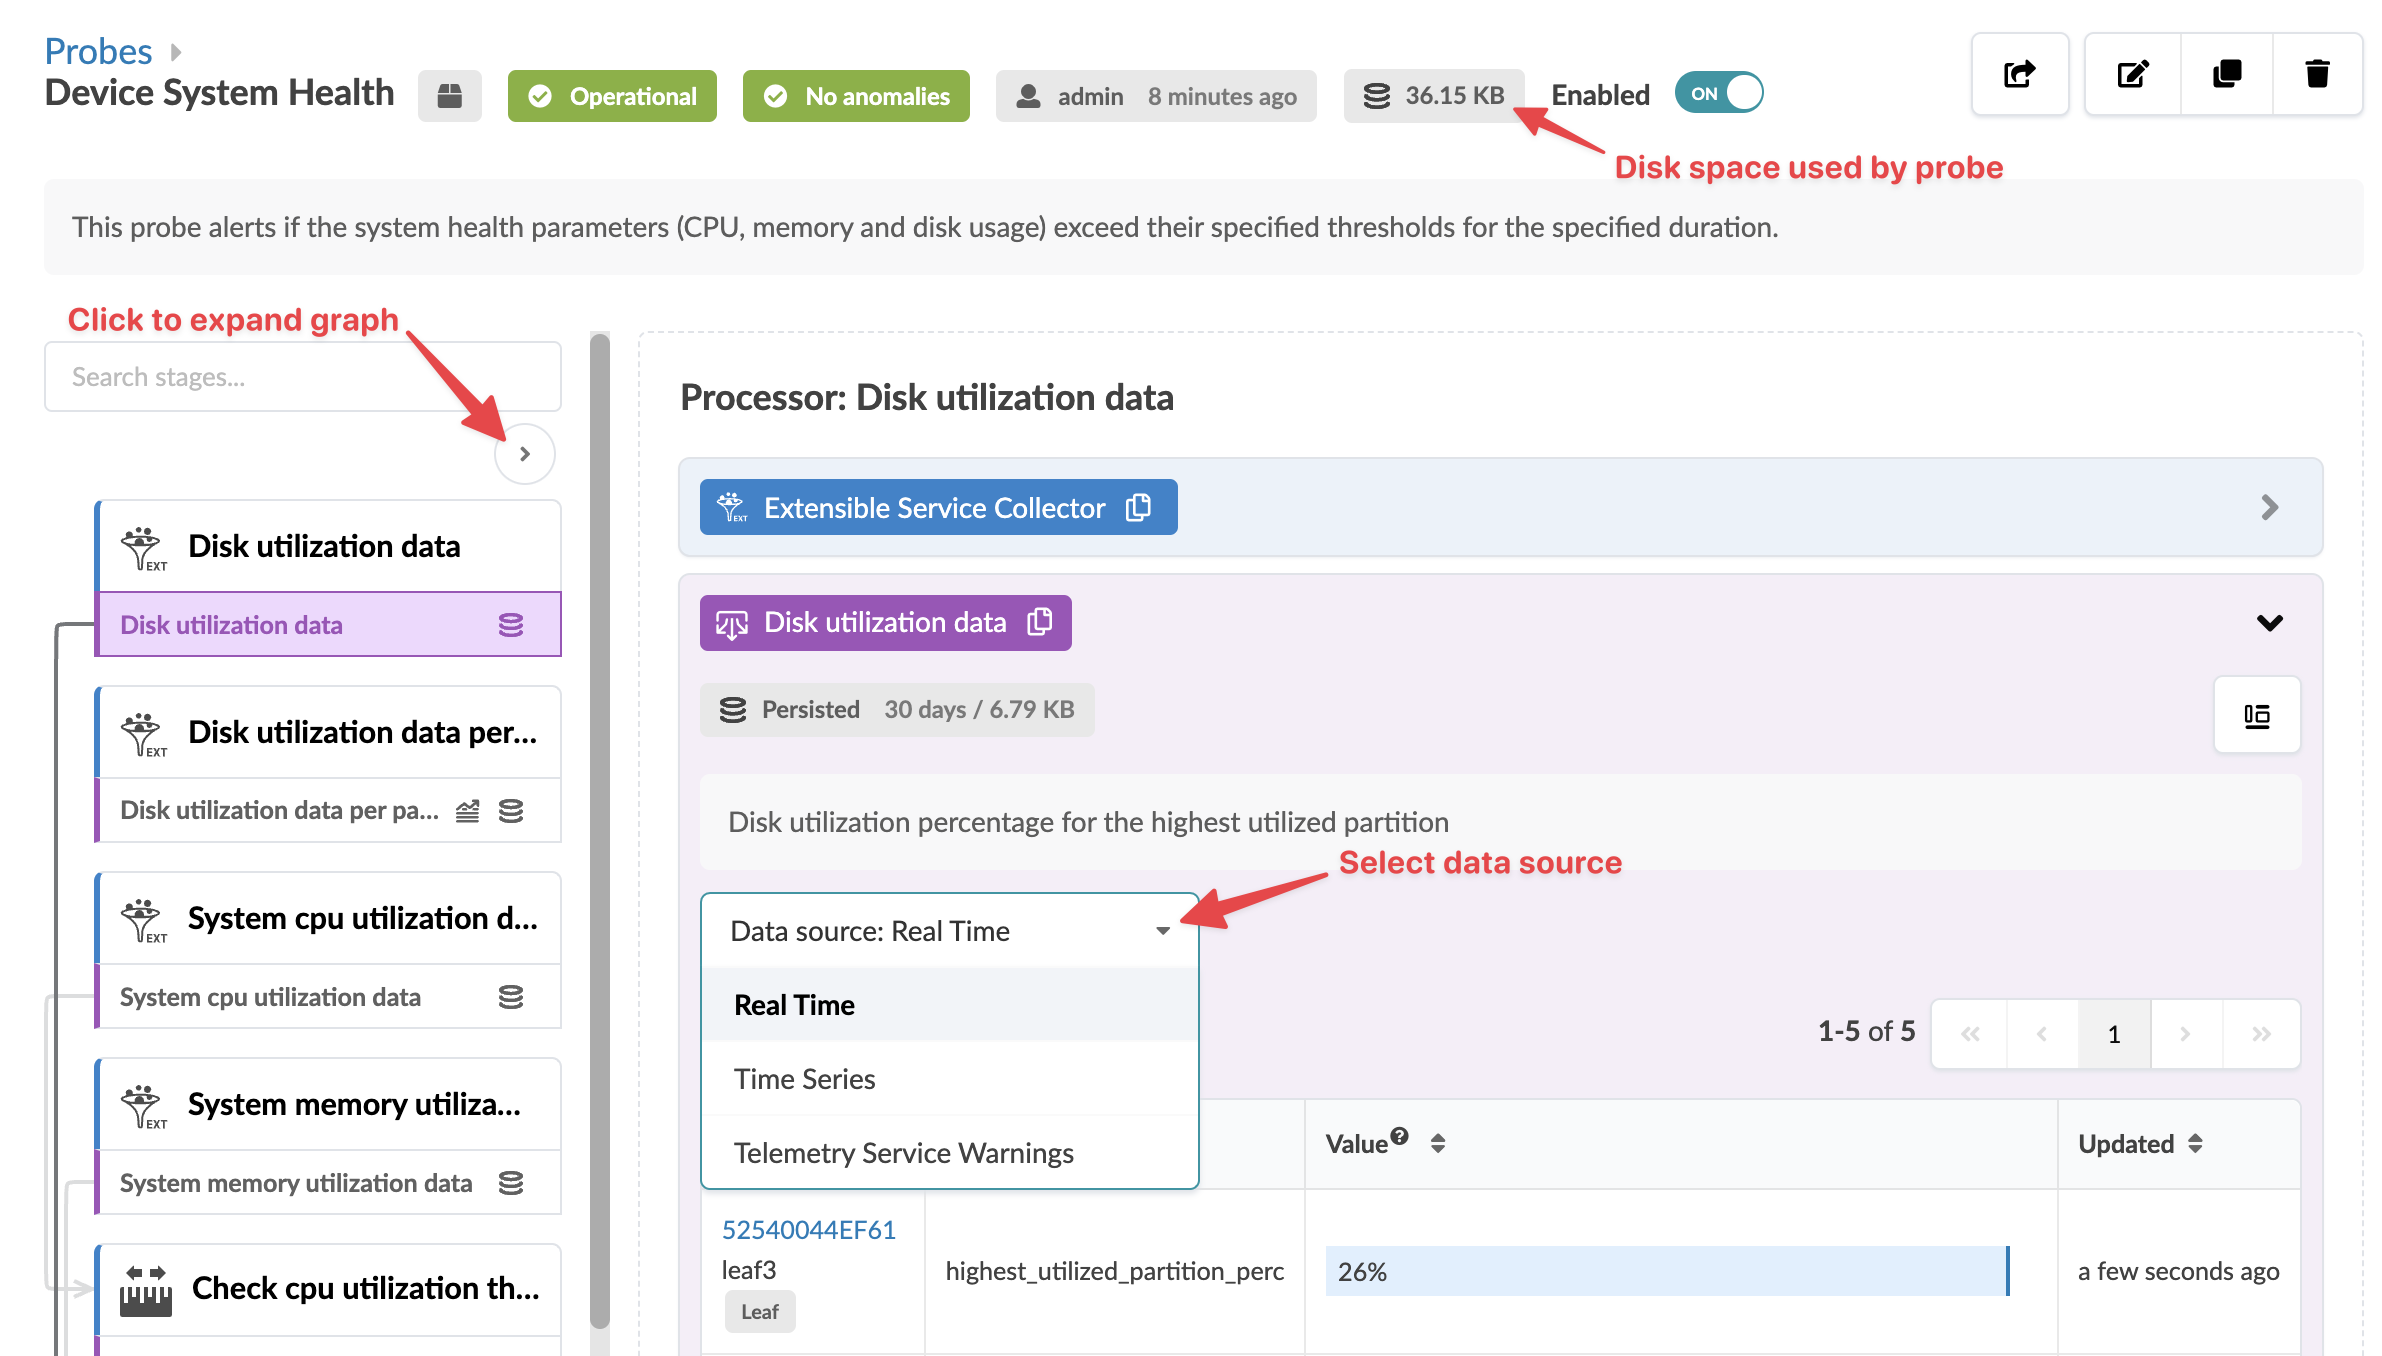
Wenn der Apstra-Controller nicht über genügend Festplattenspeicher verfügt, werden ältere Telemetriedatendateien gelöscht. Um ältere Telemetriedaten aufzubewahren, können Sie die Kapazität mit Apstra VM-Clustern erhöhen.
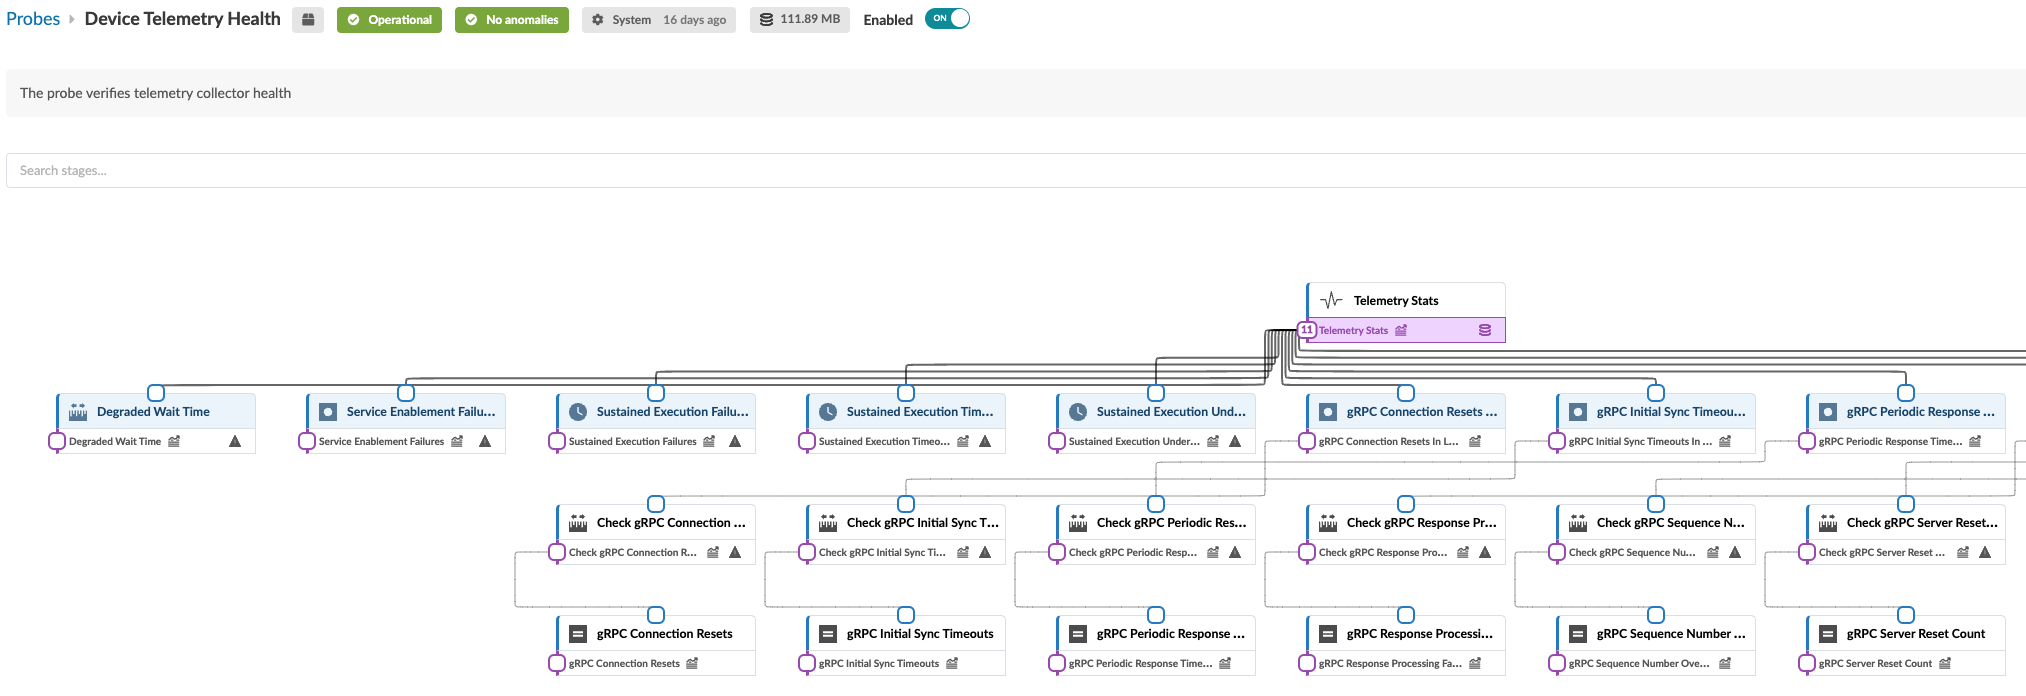
Die Struktur und Logik von nichtlinearen Sonden mit Dutzenden von Prozessoren ist in der Standardansicht nicht leicht zu unterscheiden. Sie können auf die Schaltfläche "Erweitern" (oben im linken Bereich) klicken, um eine erweiterte Darstellung der Beziehung zwischen den Prozessoren anzuzeigen. Die folgende Abbildung zeigt z. B. einen Teil der erweiterten Ansicht des Device Telemetry Health Probe.